현업에서는 FK를 안 써요. FK 쓰면 성능 떨어져요.
처음 듣는 말은 아니다. 적당히 들으면 그냥 맞는 말 같다.
근데 나는 이런 말을 그냥 끄덕이고 넘어가는 걸 잘 못한다.
똥고집이 좀 있어서.. 느리다는 건 알겠는데, 어디서? 왜? 얼마나? 갱신이 느린 건지 조회가 느린 건지, 얼마나 느린 건지도 모르고 그냥 "FK 느리다"만 외우고 다니는 게 좀 싫었다.
그래서 이번 기회에 직접 실험해서 내 눈으로 차이를 보고자 했다.
목차
- 먼저, FK는 조회랑 상관이 없다
- 그럼 쓰기는 왜 느려질까
- 실험은 FK만 빼고 다 똑같이
- 결과: FK 늘수록 진짜 느려진다 (가설 1 검증)
- 검증 못 한 가설: 락 (가설 2)
- 그래서, FK는 트레이드오프다
- TL;DR
먼저, FK는 조회랑 상관이 없다
근데 생각해보면 FK는 조회랑은 상관이 없다.
FK라는 건 "이 값이 부모에 진짜 있냐"를 지켜주는 규칙이다. 근데 이 규칙은 데이터를 넣거나 바꾸거나 지울 때만 본다. 그냥 읽기만 할 땐 FK를 거칠 이유가 없다.
그러니까 "FK 걸면 조회 느려진다"는 건 시작부터 틀린 말이다. 느려진다면 그건 쓰기다.
이건 내 추측이 아니라 공식 문서에도 그렇게 적혀 있다. FK 검사가 일어나는 작업은 INSERT·UPDATE·DELETE뿐이고, SELECT는 목록에 아예 없다.

테이블에 FOREIGN KEY 제약 조건이 정의되어 있으면, 해당 제약 조건을 확인해야 하는 INSERT, UPDATE, DELETE 작업은 제약 조건을 검사하기 위해 조회하는 레코드들에 공유 레코드 수준 락(shared record-level locks)을 설정한다. InnoDB는 제약 조건 검사가 실패하는 경우에도 이러한 락을 설정한다. — MySQL 8.0 Reference Manual — Locks Set by Different SQL Statements in InnoDB
그럼 쓰기는 왜 느려질까
내가 의심한 지점은 두 가지였다.
1. 참조 무결성 체크 비용
FK가 걸려 있으면 행 하나 넣을 때마다 DB가 "이 user_id가 users에 진짜 있어?" 하고 부모를 한 번 확인하고 넣는다. 인덱스를 타니까 빠르긴 한데, 어쨌든 한 번은 본다. 한 번이야 우습지. 근데 FK가 6개면 이 확인이 행마다 6번이다. 30만 건이면 180만 번. 이쯤 쌓이면 얘기가 달라진다.
2. 락
확인만 하고 끝이 아니다.
부모 행을 찾으면 거기에 잠깐 잠금(공유 락)을 걸어둔다.
자식을 넣는 도중에 누가 그 부모를 지워버리면 무결성이 깨지니까, "이 부모 건드리지 마" 하고 붙잡아두는 거다.
확인 비용은 그래도 예측이 된다. 행 수 × FK 개수.
근데 락은 다르다. 혼자 돌릴 땐 안 보이다가, 동시성이 끼는 순간 다른 트랜잭션이랑 부딪힌다. 이쪽이 더 까다롭다.
이번 실험은 1번만 잰다. 단일 스레드로 30만 건 INSERT 하면 락 경합이 안 일어나니까, 순수하게 확인 비용만 나온다. 2번은 동시성 환경에서야 보이는 거라 여기선 안 다룬다. 대신 마지막에 이론이랑 레퍼런스로 짧게 언급한다.
실험은 FK만 빼고 다 똑같이
"FK 때문에 느리다"고 말하려면 FK 빼곤 전부 똑같아야 한다. 컬럼도, 인덱스도, 데이터도. 하나라도 다르면 그게 범인일 수 있으니까. 그래서 아래 조건을 깔고 시작했다.
- 환경 — MySQL 8.0 / InnoDB, 로컬 도커. 회사랑 공유하는 DB는 안 건드리려고
fk_bench라는 격리 DB를 따로 팠다. - 데이터 규모
- 부모 테이블 6종: users·products·addresses 각 100만 / merchants·coupons 각 10만 / categories 1천.
- 자식 테이블은 측정마다 30만 건씩 넣었다.
- FK만 변수 — 컬럼·인덱스·데이터는 모든 단계 똑같이 두고, FK 제약 개수만 0→1→2→4→6개로 바꿨다. 이거 안 지키면 측정 자체가 의미가 없다.
- 인덱스 미리 깔기 — FK 컬럼 6개에 인덱스를 처음부터 다 박아뒀다. FK를 걸면 인덱스가 자동 생성되는데, 미리 깔아둬야 "인덱스가 새로 생겨서"가 아니라 "FK 검사 때문에" 느려졌다고 말할 수 있으니까.
- 매번 초기화 + 워밍 — 단계마다
TRUNCATE로 빈 테이블에서 시작했다(안 비우면 데이터가 쌓여서 느려진 건지 FK 때문인지 구분이 안 된다). - 유효한 FK 값 — 자식의 FK 컬럼은 부모에 실제 존재하는 id 범위에서 랜덤으로 채워서, 무결성 검사를 통과하도록 했다.
아래 펼치면 실제로 돌린 쿼리가 전부 있다.
실험에 쓴 쿼리들 (펼치기)
-- ─────────────────────────────────────────────────────────
-- Step 0. 격리 DB + 숫자 생성기 (이걸 교차조인해서 대량 행 생성)
-- ─────────────────────────────────────────────────────────
DROP DATABASE IF EXISTS fk_bench;
CREATE DATABASE fk_bench;
USE fk_bench;
SET SESSION cte_max_recursion_depth = 2000;

CREATE TABLE nums (n INT PRIMARY KEY);
INSERT INTO nums (n)
WITH RECURSIVE seq AS (SELECT 0 AS n UNION ALL SELECT n+1 FROM seq WHERE n < 999)
SELECT n FROM seq;   -- 0..999

-- ─────────────────────────────────────────────────────────
-- Step 1. 부모(차원) 테이블 6종 + 적재
-- ─────────────────────────────────────────────────────────
-- users 100만
CREATE TABLE users (
  id BIGINT PRIMARY KEY, email VARCHAR(120) NOT NULL, name VARCHAR(50) NOT NULL,
  phone VARCHAR(20) NOT NULL, status VARCHAR(20) NOT NULL, point INT NOT NULL,
  created_at DATETIME(6) NOT NULL
) ENGINE=InnoDB;
INSERT INTO users (id, email, name, phone, status, point, created_at)
SELECT a.n*1000+b.n, CONCAT('user', a.n*1000+b.n, '@loopers.com'),
       CONCAT('사용자', a.n*1000+b.n), CONCAT('010', LPAD(FLOOR(RAND()*1e8),8,'0')),
       ELT(1+FLOOR(RAND()*3),'ACTIVE','DORMANT','BANNED'),
       FLOOR(RAND()*100000), NOW(6) - INTERVAL FLOOR(RAND()*1000) DAY
FROM nums a CROSS JOIN nums b;

-- products 100만
CREATE TABLE products (
  id BIGINT PRIMARY KEY, name VARCHAR(120) NOT NULL, price DECIMAL(12,2) NOT NULL,
  stock INT NOT NULL, status VARCHAR(20) NOT NULL, created_at DATETIME(6) NOT NULL
) ENGINE=InnoDB;
INSERT INTO products (id, name, price, stock, status, created_at)
SELECT a.n*1000+b.n, CONCAT('상품-', a.n*1000+b.n), ROUND(RAND()*490000+1000,2),
       FLOOR(RAND()*1000), ELT(1+FLOOR(RAND()*2),'ON_SALE','SOLD_OUT'),
       NOW(6) - INTERVAL FLOOR(RAND()*500) DAY
FROM nums a CROSS JOIN nums b;

-- addresses 100만
CREATE TABLE addresses (
  id BIGINT PRIMARY KEY, zipcode VARCHAR(10) NOT NULL, line1 VARCHAR(200) NOT NULL,
  line2 VARCHAR(100), recipient VARCHAR(50) NOT NULL, created_at DATETIME(6) NOT NULL
) ENGINE=InnoDB;
INSERT INTO addresses (id, zipcode, line1, line2, recipient, created_at)
SELECT a.n*1000+b.n, LPAD(FLOOR(RAND()*100000),5,'0'),
       CONCAT('서울시 ', a.n*1000+b.n, '로'), CONCAT(FLOOR(RAND()*1000),'호'),
       CONCAT('받는이', a.n*1000+b.n), NOW(6)
FROM nums a CROSS JOIN nums b;

-- merchants 10만
CREATE TABLE merchants (
  id BIGINT PRIMARY KEY, name VARCHAR(100) NOT NULL, region VARCHAR(30) NOT NULL,
  created_at DATETIME(6) NOT NULL
) ENGINE=InnoDB;
INSERT INTO merchants (id, name, region, created_at)
SELECT a.n*100+b.n, CONCAT('판매자-', a.n*100+b.n),
       ELT(1+FLOOR(RAND()*5),'SEOUL','BUSAN','DAEGU','INCHEON','GWANGJU'), NOW(6)
FROM nums a CROSS JOIN nums b WHERE b.n < 100;

-- coupons 10만
CREATE TABLE coupons (
  id BIGINT PRIMARY KEY, code VARCHAR(30) NOT NULL, discount_rate INT NOT NULL,
  valid_until DATE NOT NULL
) ENGINE=InnoDB;
INSERT INTO coupons (id, code, discount_rate, valid_until)
SELECT a.n*100+b.n, CONCAT('CPN', LPAD(a.n*100+b.n,8,'0')),
       ELT(1+FLOOR(RAND()*4),5,10,15,20), DATE_ADD(CURDATE(), INTERVAL FLOOR(RAND()*365) DAY)
FROM nums a CROSS JOIN nums b WHERE b.n < 100;

-- categories 1천
CREATE TABLE categories (id BIGINT PRIMARY KEY, name VARCHAR(50) NOT NULL) ENGINE=InnoDB;
INSERT INTO categories (id, name) SELECT n, CONCAT('카테고리-', n) FROM nums;

-- ─────────────────────────────────────────────────────────
-- Step 2. 거래(자식) 테이블 — 17컬럼 + FK컬럼6 + 인덱스6 (FK 제약은 아직 없음)
-- ─────────────────────────────────────────────────────────
CREATE TABLE transactions (
  id BIGINT AUTO_INCREMENT PRIMARY KEY,
  user_id BIGINT NOT NULL, product_id BIGINT NOT NULL, merchant_id BIGINT NOT NULL,
  category_id BIGINT NOT NULL, address_id BIGINT NOT NULL, coupon_id BIGINT NOT NULL,
  order_no VARCHAR(40) NOT NULL, quantity INT NOT NULL,
  unit_price DECIMAL(12,2) NOT NULL, discount_amount DECIMAL(12,2) NOT NULL,
  total_amount DECIMAL(12,2) NOT NULL, payment_method VARCHAR(20) NOT NULL,
  status VARCHAR(20) NOT NULL, memo VARCHAR(255),
  created_at DATETIME(6) NOT NULL, updated_at DATETIME(6) NOT NULL,
  KEY k_user(user_id), KEY k_product(product_id), KEY k_merchant(merchant_id),
  KEY k_category(category_id), KEY k_address(address_id), KEY k_coupon(coupon_id)
) ENGINE=InnoDB;

-- 측정용 INSERT (30만 건) — Step 3~7에서 매번 이 블록을 재사용
INSERT INTO transactions
  (user_id, product_id, merchant_id, category_id, address_id, coupon_id,
   order_no, quantity, unit_price, discount_amount, total_amount,
   payment_method, status, memo, created_at, updated_at)
SELECT FLOOR(RAND()*1000000), FLOOR(RAND()*1000000), FLOOR(RAND()*100000),
       FLOOR(RAND()*1000), FLOOR(RAND()*1000000), FLOOR(RAND()*100000),
       CONCAT('ORD-', LPAD(a.n*1000+b.n,12,'0')), 1+FLOOR(RAND()*5),
       ROUND(RAND()*100000,2), ROUND(RAND()*5000,2), ROUND(RAND()*100000,2),
       ELT(1+FLOOR(RAND()*3),'CARD','BANK','POINT'),
       ELT(1+FLOOR(RAND()*4),'PAID','PENDING','CANCELLED','REFUNDED'),
       CONCAT('주문메모 ', a.n*1000+b.n), NOW(6), NOW(6)
FROM nums a CROSS JOIN nums b WHERE a.n < 300;

-- ─────────────────────────────────────────────────────────
-- Step 3~7. FK를 0→1→2→4→6개로 늘려가며 매 단계 측정
--   각 단계: TRUNCATE → (FK 추가) → 위 '측정용 INSERT' 실행 → 시간 기록
--   ※ 캐시 워밍 위해 한 번 더 돌려 두 번째 값 사용
-- ─────────────────────────────────────────────────────────
-- [FK 0개] 기준선: 위 측정용 INSERT 그대로 실행

-- [FK 1개]
TRUNCATE transactions;
ALTER TABLE transactions ADD CONSTRAINT fk_user     FOREIGN KEY (user_id)     REFERENCES users(id);
-- → 측정용 INSERT 실행

-- [FK 2개]
TRUNCATE transactions;
ALTER TABLE transactions ADD CONSTRAINT fk_product  FOREIGN KEY (product_id)  REFERENCES products(id);
-- → 측정용 INSERT 실행

-- [FK 4개]
TRUNCATE transactions;
ALTER TABLE transactions ADD CONSTRAINT fk_merchant FOREIGN KEY (merchant_id) REFERENCES merchants(id);
ALTER TABLE transactions ADD CONSTRAINT fk_category FOREIGN KEY (category_id) REFERENCES categories(id);
-- → 측정용 INSERT 실행

-- [FK 6개]
TRUNCATE transactions;
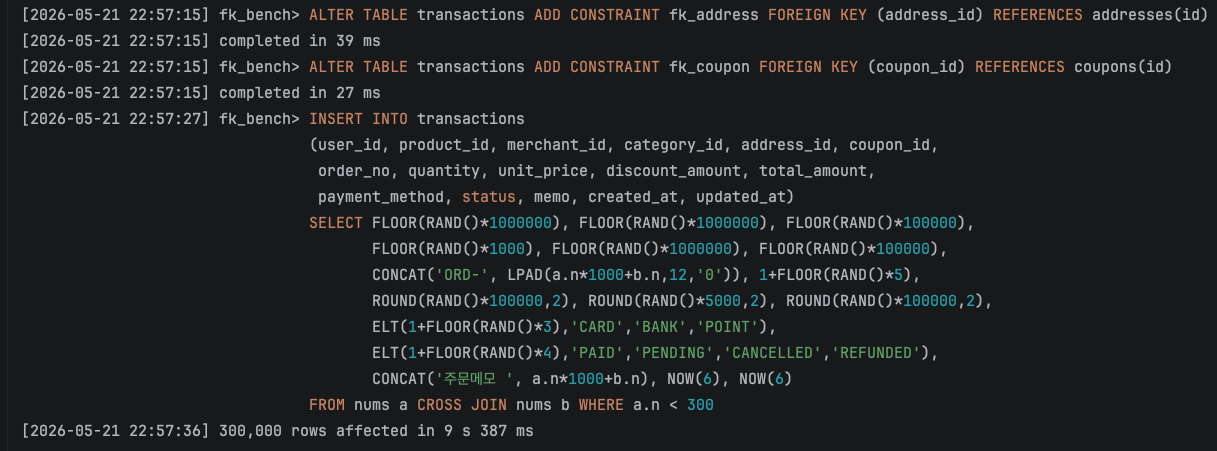
ALTER TABLE transactions ADD CONSTRAINT fk_address  FOREIGN KEY (address_id)  REFERENCES addresses(id);
ALTER TABLE transactions ADD CONSTRAINT fk_coupon   FOREIGN KEY (coupon_id)   REFERENCES coupons(id);
-- → 측정용 INSERT 실행
결과: FK 늘수록 진짜 느려진다 (가설 1 검증)
숫자부터 보자.
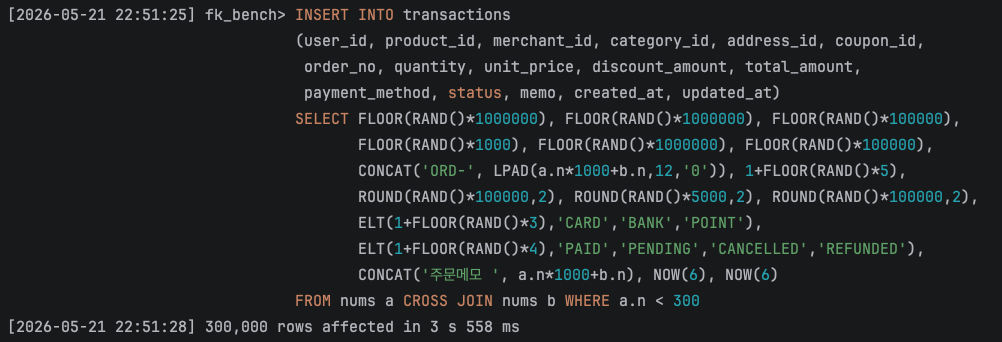
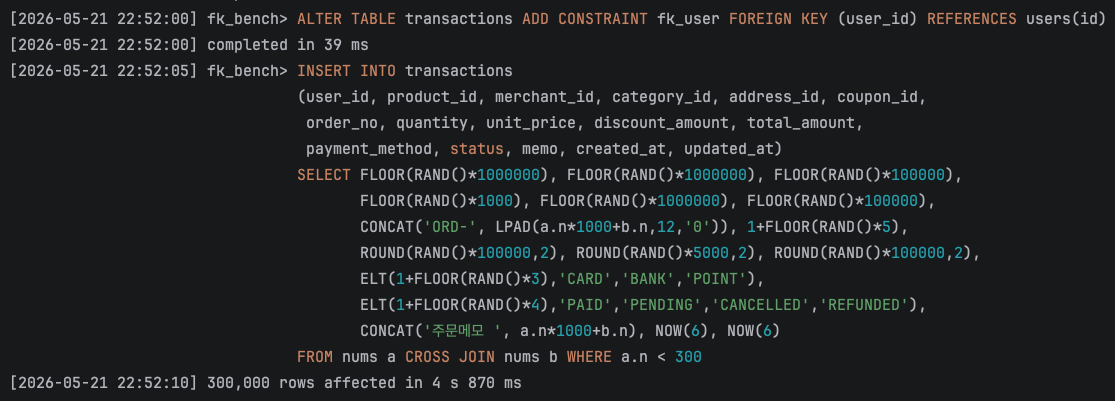
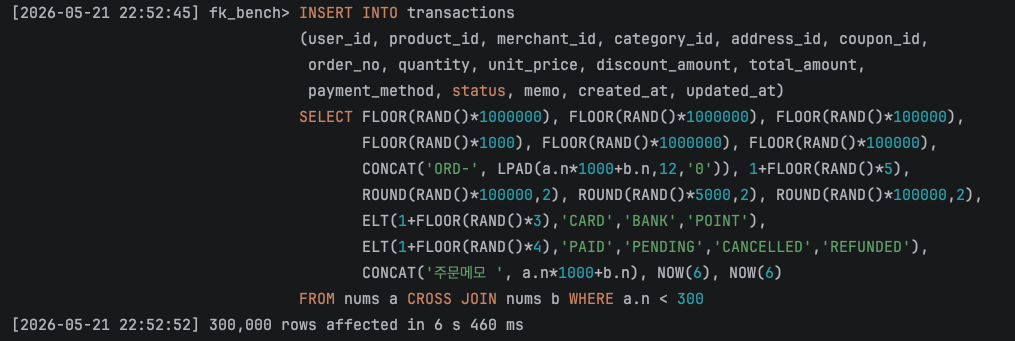
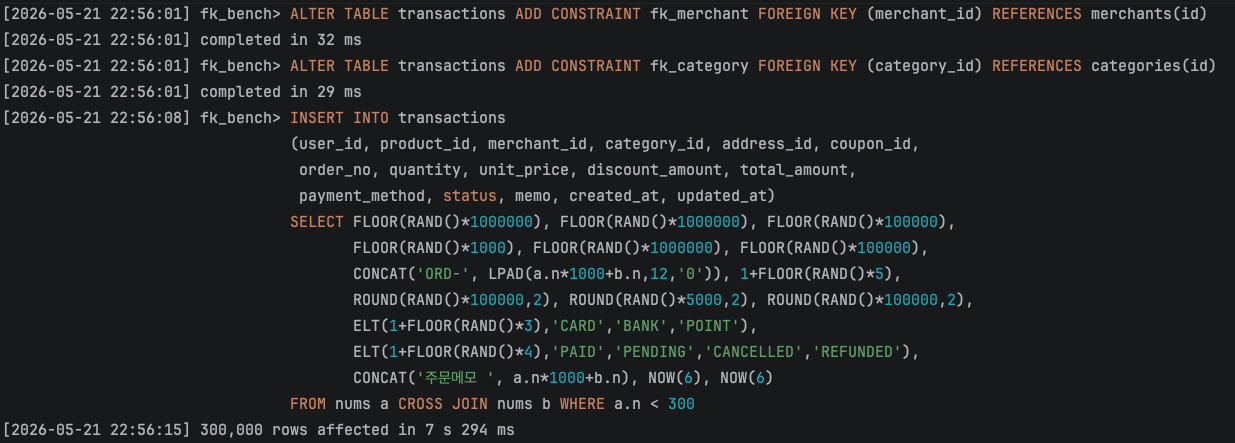
| FK 개수 | INSERT 30만 건 소요 시간 | FK 0개 대비 |
|---|---|---|
| 0개 | 3s 558ms | 1.00× |
| 1개 | 4s 870ms | 1.37× |
| 2개 | 6s 460ms | 1.82× |
| 4개 | 7s 294ms | 2.05× |
| 6개 | 9s 387ms | 2.64× |
FK 하나도 없을 때 대비 6개에서 2.6배. 대충 FK 하나당 1초쯤 더 붙는 셈이다. 멘토님 말이 맞았다. FK는 쓰기에서 분명히 느리다.
FK 0개 - 3s 558ms 소요
FK 1개 - 4s 870ms 소요
FK 2개 - 6s 460ms 소요
FK 4개 - 7s 294ms 소요
FK 6개 - 9s 387ms 소요
숫자를 좀 곱씹어보면
근데 증가 폭이 좀 이상하다.
- 0 → 1개 (
+user, 100만): +1.3초 (37% 증가) - 1 → 2개 (
+product, 100만): +1.6초 (33% 증가) - 2 → 4개 (
+merchant10만,+category1천): +0.8초, FK 1개당 +0.4초 - 4 → 6개 (
+address100만,+coupon10만): +2.1초, FK 1개당 +1.0초
선형이 아니다. "FK 하나 추가 = 1초 추가" 같은 깔끔한 공식이 안 먹힌다. 2→4 구간은 유독 완만하고, 4→6 구간에서 다시 가팔라진다.
2→4에서 붙은 게 merchants(10만)랑 categories(1천)다. 부모가 작으면 인덱스 전체가 메모리에 잘 올라간다. categories는 1천 건이라 사실상 한 페이지 안에 다 들어가서, FK 검사 한 번이 거의 공짜에 가깝다. 반대로 4→6에서 붙은 addresses는 100만 건짜리라 인덱스 탐색 깊이도 깊고 캐시 미스도 더 잘 난다.
그래서 FK 1개당 N초가 아니라, 참조하는 부모 테이블 크기에 따라 비용이 달라진다가 더 정확한 해석이다.
FK 6개 다 걸고도 비용이 비슷할 수도, 훨씬 클 수도 있다. 부모가 뭐냐에 달렸다.
물론 한 번씩만 잰 거라 단정은 못 한다. 다만 "FK 하나가 무조건 N초"라는 단순한 모델은 틀렸다는 정도는 말할 수 있다.
절대값엔 의미를 두지 말자
이건 짚고 가자. 이 초 단위 절대값(3.5초, 9.3초 같은)에는 의미를 두지 말자. 하드웨어·MySQL 설정·버퍼 풀 크기 같은 환경 스펙마다 얼마든지 달라지는 숫자다. 게다가 한 번씩만 쟀더니 단계별 증가폭도 들쭉날쭉했다 — 위에서 본 2→4 구간이 유독 완만한 것도 그냥 우연일 수 있다. 제대로 하려면 각 단계를 여러 번 돌려 중앙값 보고, 분산까지 확인했어야 한다. (거기까진 못 했다..)
봐야 할 건 두 가지다.
- 배율 — FK 없을 때 대비 몇 배냐. 환경이 바뀌어도 이 비율은 비슷하게 유지된다.
- 경향 — FK가 늘수록 느려진다. 그리고 그 느려지는 정도는 부모 테이블 크기에 영향을 받는다.
이 두 개는 환경이 바뀌어도 방향이 안 흔들린다. 가설 1은 이렇게 확인됐다. 참조 무결성 체크는 누적되는 비용이고, 그 비용은 부모 테이블 크기에 따라 달라진다.
검증 못 한 가설: 락 (가설 2)
남은 게 가설 2, 락이다. 이건 못 재는 게 아니다. 동시성 환경만 깔면 잴 수 있다. 근데 이번 글에서 검증은 안하고 넘어가려고 한다.
왜 미루냐면, 동시성은 변수가 너무 많다. 스레드를 몇 개로 때릴지, 같은 행에 얼마나 몰아칠지, 격리 수준은 뭘로 둘지에 따라 숫자가 통째로 바뀐다.
가설 1처럼 "FK 개수만 변수"로 깨끗하게 안 떨어진다.
이걸 이 글에 욱여넣으면 애써 깨끗하게 잰 가설 1까지 같이 지저분해진다. 그래서 한 편 따로 잡는 게 맞다고 봤다. (그리고 이것만으로도 글 하나 분량이다..)
대신 방향만 짚고 넘어가자.
현업은 혼자가 아니다. 인기 상품 하나에 주문이 동시에 수백 건씩 몰리고, 거기에 그 상품 재고를 깎는 UPDATE까지 끼어든다고 해보자. FK가 그 상품 행에 걸어둔 공유 락이랑, 재고를 바꾸려는 배타 락이 서로 부딪힌다. 줄을 서고, 꼬이면 데드락도 난다.
그래서 이번에 잰 2.6배는 끝 숫자가 아니라 바닥 숫자에 가깝다. 단일 스레드라 락 대기가 0이었던 거고, 동시성이 끼면 그 위에 대기 시간이 또 얹힌다. 얼마나 얹히는지는 워크로드마다 다르겠지만, 방향은 뻔하다. 분명 더 느려진다.
Percona도 FK 락이 다른 테이블로까지 번지면서 경합을 만든다고 짚는다. (Hidden Cost of Foreign Key Constraints)
그래서, FK는 트레이드오프다
FK 쓰기 비용은 실재한다. 6개를 다 걸면 단일 스레드로도 2.6배, 동시성까지 가면 더 커질 거다. 문제가 없다는 게 아니다. 분명히 비용이다.
근데 FK를 빼는 것도 공짜가 아니다.
FK가 막아주던 것
- "부모 없는 자식은 못 들어온다"는 정합성을
- 이제 애플리케이션이 직접 짊어져야 한다. 주문을 넣기 전에 코드에서 유저가 있는지 확인하고, 동시에 여러 요청이 들어와도 그게 안 깨지게 막아야 한다.
결국 트레이드오프다.
쓰기 성능을 얻는 대신 정합성 책임을 내 코드로 가져오느냐, 아니면 그 책임을 DB에 맡기는 대신 쓰기 비용을 내느냐. 애플리케이션에서 논리적으로 막을 수는 있다. 다만 "막을 수 있다"랑 "DB가 보장한다"는 다르다. 전자는 내가 안 틀려야 성립하고, 후자는 내가 틀려도 DB가 막아준다.
"FK 쓰지 마"도, "FK 무조건 걸어"도 둘 다 반쪽짜리다. 비용을 어디서 낼지 정하는 문제일 뿐이다.
TL;DR
FK는 조회랑 상관없고, 느려지는 건 쓰기다. 단일 스레드 30만 건 INSERT로 재보니 FK 0개 대비 6개에서 2.6배 느려졌다. 근데 "FK 1개당 N초"는 틀렸고, 참조하는 부모 테이블이 얼마나 크냐에 따라 비용이 달라진다. 결국 FK는 "쓰지 마/무조건 걸어"가 아니라, 정합성 책임을 DB에 맡길지 내 코드로 가져올지의 트레이드오프다.